게시글 목록 API에서 게시글 제목과 작성자 이름을 함께 반환하는 기능을 만들었다.
Post와 Member는 다대일 관계이고 연관관계는 LAZY로 설정했다. 기능은 정상적으로 동작했지만 Hibernate SQL 로그를 확인해보니 게시글을 조회한 뒤 members 테이블을 조회하는 SELECT가 반복되고 있었다.
이번에는 이 현상을 직접 재현하고 실제 SQL 횟수를 확인한 뒤 Fetch Join과 EntityGraph를 적용해 비교했다.
마지막에는 Comment 컬렉션까지 Fetch Join해보면서 조회 쿼리를 한 번으로 줄이는 것이 항상 적절한지도 확인했다.
1. 문제 발견 — 목록 조회 한 번에 SELECT가 11번 실행됐다
실험 데이터는 다음과 같이 준비했다.
| 데이터 | 개수 |
| Member | 10개 |
| Post | 100개 |
Post 100개를 Member 10명에게 순환해서 배정했다.
post-1  → member-1
post-2  → member-2
...
post-10 → member-10
post-11 → member-1
...
Post.member는 LAZY로 설정했다.
@ManyToOne(fetch = FetchType.LAZY, optional = false)
@JoinColumn(name = "member_id", nullable = false)
private Member member;
목록 조회에서는 별도의 JPQL 없이 JpaRepository의 findAll()을 사용했다.
@Transactional(readOnly = true)
public List<PostResponse> getPosts() {
    return postRepository.findAll().stream()
            .map(post -> new PostResponse(
                    post.getId(),
                    post.getTitle(),
                    post.getMember().getName()
            ))
            .toList();
}
실제로 GET /posts를 한 번 호출한 뒤 Hibernate SQL을 확인했다.
| 구분 | 실제 SQL 횟수 |
| Post SELECT | 1회 |
| Member SELECT | 10회 |
| 전체 SELECT | 11회 |
Post 목록을 가져오는 SQL은 한 번 실행됐다.
select
    p1_0.id,
    p1_0.member_id,
    p1_0.title
from
    posts p1_0
그 뒤 다음과 같은 Member 조회가 반복됐다.
select
    m1_0.id,
    m1_0.name
from
    members m1_0
where
    m1_0.id=?
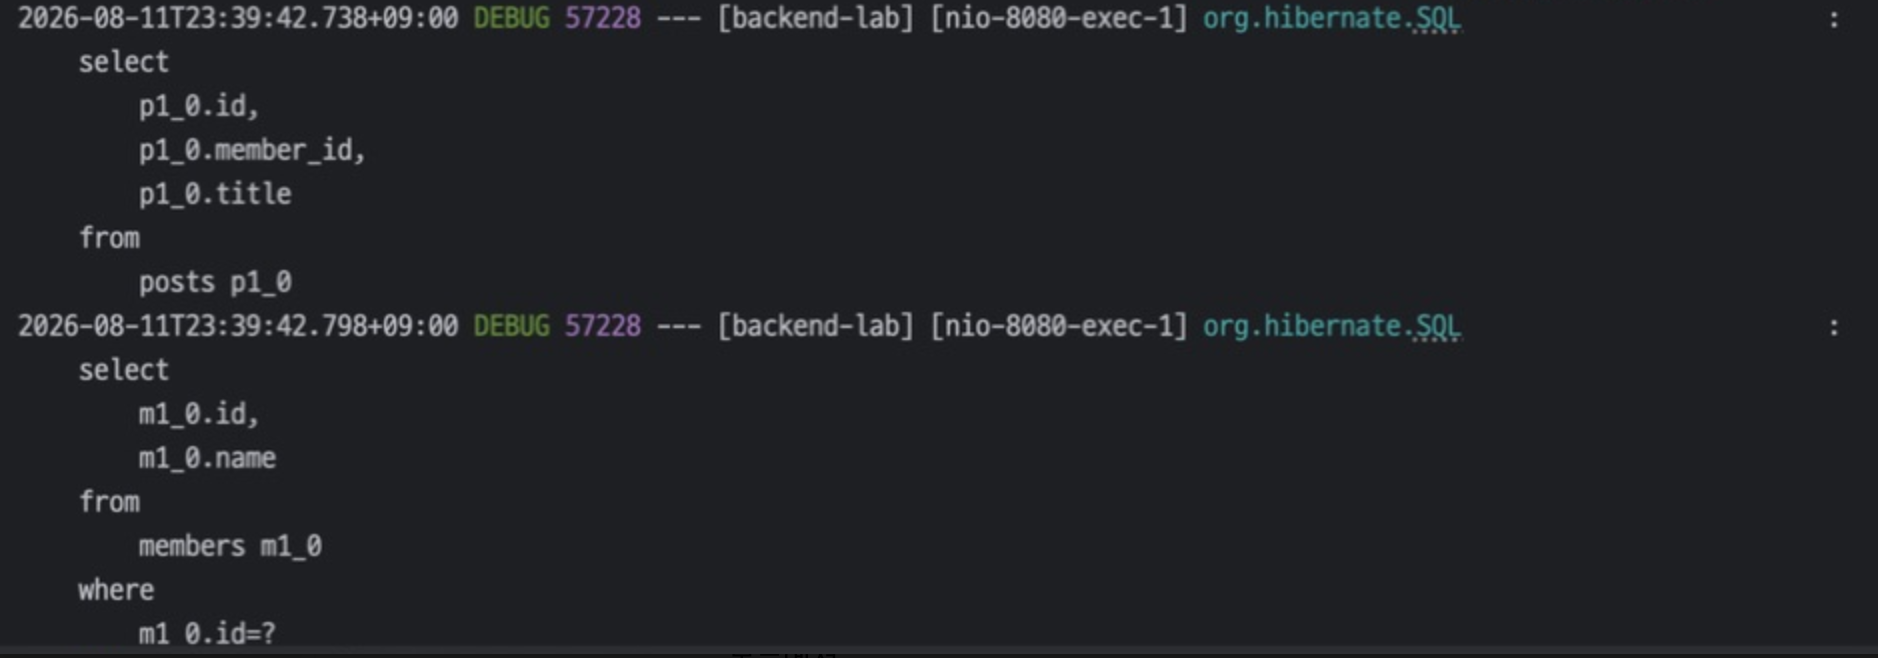
이번 실험에서는 Post가 100개였지만 Member는 10명을 반복해서 참조하고 있었고, 실제 Member SELECT는 10회가 발생했다.
Post 목록 조회 1회
+
Member 추가 조회 10회
=
전체 SELECT 11회
목록을 한 번 조회했다고 해서 실제 DB 조회도 한 번으로 끝나는 것은 아니었다.
2. 문제 원인 — 작성자 이름에 접근하는 순간 추가 조회가 발생했다
SQL이 추가로 발생한 지점은 DTO 변환 부분이었다.
post.getMember().getName()
Post.member는 LAZY로 설정돼 있다.
따라서 Post 목록을 조회하는 시점에는 Member 데이터까지 함께 가져오지 않고, 이후 실제로 Member 데이터가 필요한 시점에 조회가 발생한다.
이번 API에서는 모든 게시글에서 작성자 이름을 응답해야 했다.
Post 목록 조회
        ↓
DTO 변환
        ↓
Member 이름 필요
        ↓
Member 추가 SELECT
그리고 이 과정이 목록을 처리하면서 반복됐다.
이처럼 하나의 목록 조회 이후 연관 엔티티를 사용하는 과정에서 추가 SELECT가 반복되는 현상을 N+1 문제라고 한다.
여기서 LAZY 자체가 잘못된 설정이라고 보기는 어려웠다.
작성자 정보가 필요하지 않은 조회라면 Member를 처음부터 가져오지 않는 것이 오히려 불필요한 데이터를 조회하지 않는 방법이 될 수 있다.
문제는 이번 API에서는 모든 Post에서 Member 이름을 사용한다는 점이었다.
그렇다면 애초에 Post와 Member를 함께 조회하는 편이 낫지 않을까 하는 생각이 들었다.
3. 해결 방법 고민 — Fetch Join과 EntityGraph를 비교해보기로 했다
N+1을 줄이는 방법을 확인하기 위해 이번에는 두 가지 조회 방식을 비교했다.
Baseline
→ LAZY + findAll()

Fetch Join
→ JPQL에서 Member를 같이 조회

EntityGraph
→ 이번 조회에서 Member를 함께 가져오도록 지정
같은 조건에서 실행해 실제 SQL이 어떻게 달라지는지 확인했다.
성능 지표를 비교하는 것이 아니라 SQL 횟수와 실제 생성 SQL이 어떻게 변하는지에 초점을 맞췄다.
4. 해결 1 — Fetch Join으로 추가 Member SELECT를 없앴다
먼저 Fetch Join을 적용했다.
@Query("select p from Post p join fetch p.member")
List<Post> findAllWithMember();
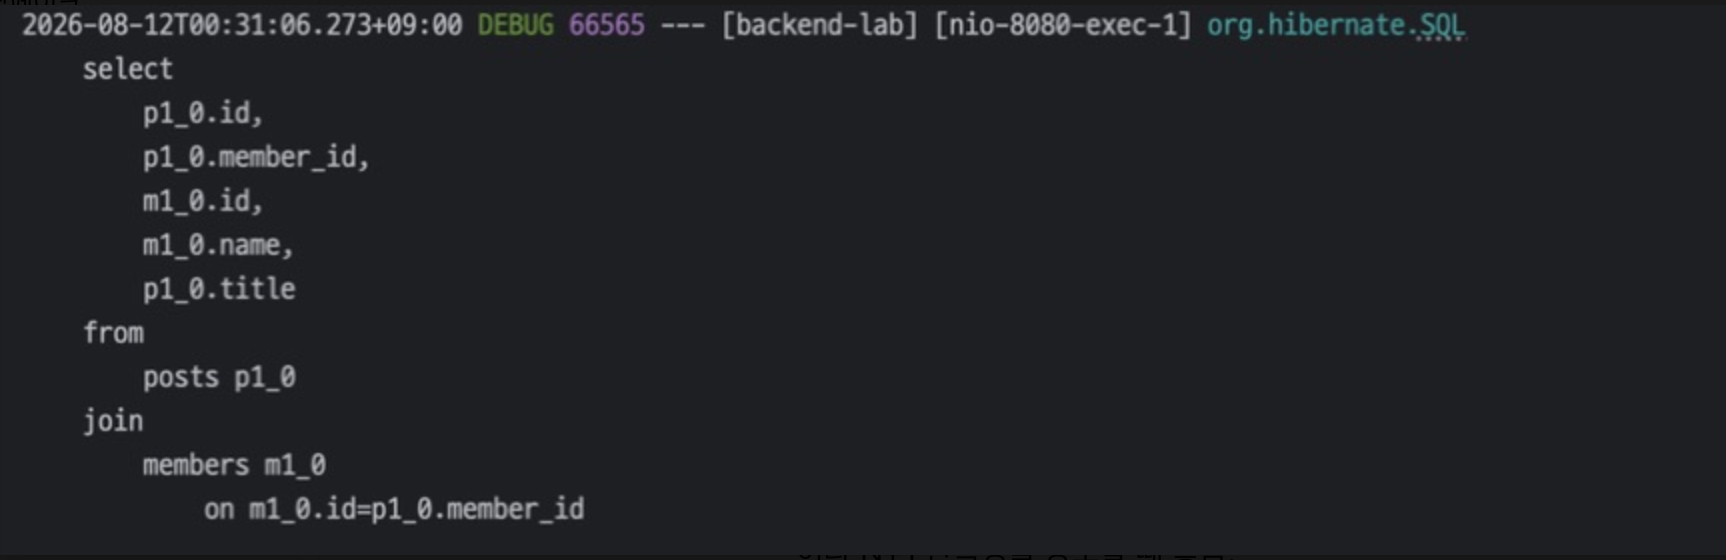
실제로 생성된 SQL은 다음과 같았다.
select
    p1_0.id,
    p1_0.member_id,
    m1_0.id,
    m1_0.name,
    p1_0.title
from
    posts p1_0
join
    members m1_0
        on m1_0.id=p1_0.member_id
기존에는 Post를 조회한 뒤 Member SELECT가 추가로 실행됐다.
Fetch Join을 사용하자 posts와 members가 하나의 SQL에서 JOIN됐다.
📷
같은 Member 10명, Post 100개의 조건으로 다시 실행한 결과는 다음과 같았다.
| 구분 | 실제 SQL 횟수 |
| Post + Member JOIN SELECT | 1회 |
| Member 추가 SELECT | 0회 |
| 전체 SELECT | 1회 |
Baseline
11회

↓

Fetch Join
1회
다만 이번 실험에서는 응답시간, TPS, CPU 사용량 등을 측정하지 않았다.
따라서 성능이 몇 배 좋아졌다고 표현하지 않고, 추가 Member SELECT가 사라지고 전체 SELECT가 11회에서 1회로 바뀌었다는 사실만 확인했다.
5. 다른 해결 방법 — EntityGraph도 같은 조건에서 확인했다
Fetch Join만 가능한 방법인지 확인하기 위해 EntityGraph도 적용했다.
@EntityGraph(attributePaths = "member")
@Query("select p from Post p")
List<Post> findAllWithMemberByEntityGraph();
같은 조건에서 실행한 결과는 다음과 같았다.
| 방식 | Post SELECT | Member 추가 SELECT | 전체 SELECT |
| Baseline | 1회 | 10회 | 11회 |
| Fetch Join | 1회 | 0회 | 1회 |
| EntityGraph | 1회 | 0회 | 1회 |
이번 실험에서는 EntityGraph도 Post와 Member를 JOIN한 SQL 한 번을 실행했다.
더 흥미로웠던 점은 이번 단순한 Post → Member 조회에서는 Fetch Join과 EntityGraph가 생성한 SQL의 선택 컬럼과 JOIN 형태도 동일했다는 것이다. Fetch Join은 JPQL에서 join fetch를 직접 작성하고, EntityGraph는 조회 시 함께 가져올 연관관계를 별도로 지정한다는 작성 방식의 차이가 있었다. 이번 결과만 놓고 한 방법이 항상 더 낫다고 결론 내리기는 어려웠다.
6. 추가 고민 — 그러면 Fetch Join을 항상 사용하면 될까?
여기까지 결과만 보면 Post와 Member를 항상 Fetch Join하면 될 것처럼 보였다.
그래서 관계를 하나 더 추가해봤다.
이번에는 Post 하나에 여러 Comment가 존재하도록 했다.
@OneToMany(mappedBy = "post", fetch = FetchType.LAZY)
private List<Comment> comments = new ArrayList<>();
댓글 데이터는 다음과 같이 만들었다.
Post 1 → Comment 3개
Post 2 → Comment 2개
Post 3 → Comment 1개
나머지 Post → Comment 없음
그리고 Member와 Comments를 함께 Fetch Join했다.
@Query("""
    select p
    from Post p
    join fetch p.member
    left join fetch p.comments
""")
List<Post> findAllWithComments();
SQL은 한 번 실행됐다.
하지만 DB 결과를 직접 확인해보니 새로운 차이가 보였다.
| 항목 | 실제 결과 |
| 원래 Post | 100개 |
| DB JOIN Row | 103 Row |
| 고유 Post | 100개 |
| JPA 반환 Post | 100개 |
Post 1에는 Comment가 3개 있었다.
따라서 DB JOIN 결과에서는 다음과 같이 Post 1 정보가 반복됐다.
Post 1 + Comment 1
Post 1 + Comment 2
Post 1 + Comment 3

Post 2 + Comment 4
Post 2 + Comment 5

Post 3 + Comment 6
결과적으로 기본 100 Row에서 Post 1 때문에 2 Row, Post 2 때문에 1 Row가 추가돼 103 Row가 됐다.
이번 Hibernate 실행에서는 DB JOIN 결과가 103 Row였지만 최종적으로 반환된 Post는 100개였고 중복 Post ID 그룹도 없었다.
여기서 SQL 한 번으로 조회하는 것만 보는 것이 아니라 JOIN 결과가 얼마나 커지는지도 함께 확인해야 한다는 점을 알 수 있었다.
7. 제약 확인 — Collection Fetch Join에 Pagination을 붙여봤다
마지막으로 Collection Fetch Join에 Pageable을 함께 적용했다.
@Query(
    value = """
        select p
        from Post p
        join fetch p.member
        left join fetch p.comments
    """,
    countQuery = "select count(p) from Post p"
)
Page<Post> findAllWithComments(Pageable pageable);
실제 요청은 다음과 같았다.
GET /posts/collection-fetch-join/page?page=0&size=10
API 응답에서는 Post 10개가 반환됐다.
하지만 Hibernate 로그에서 warning이 발생했다.
HHH90003004:
firstResult/maxResults specified with collection fetch;
applying in memory
<aside>
📷
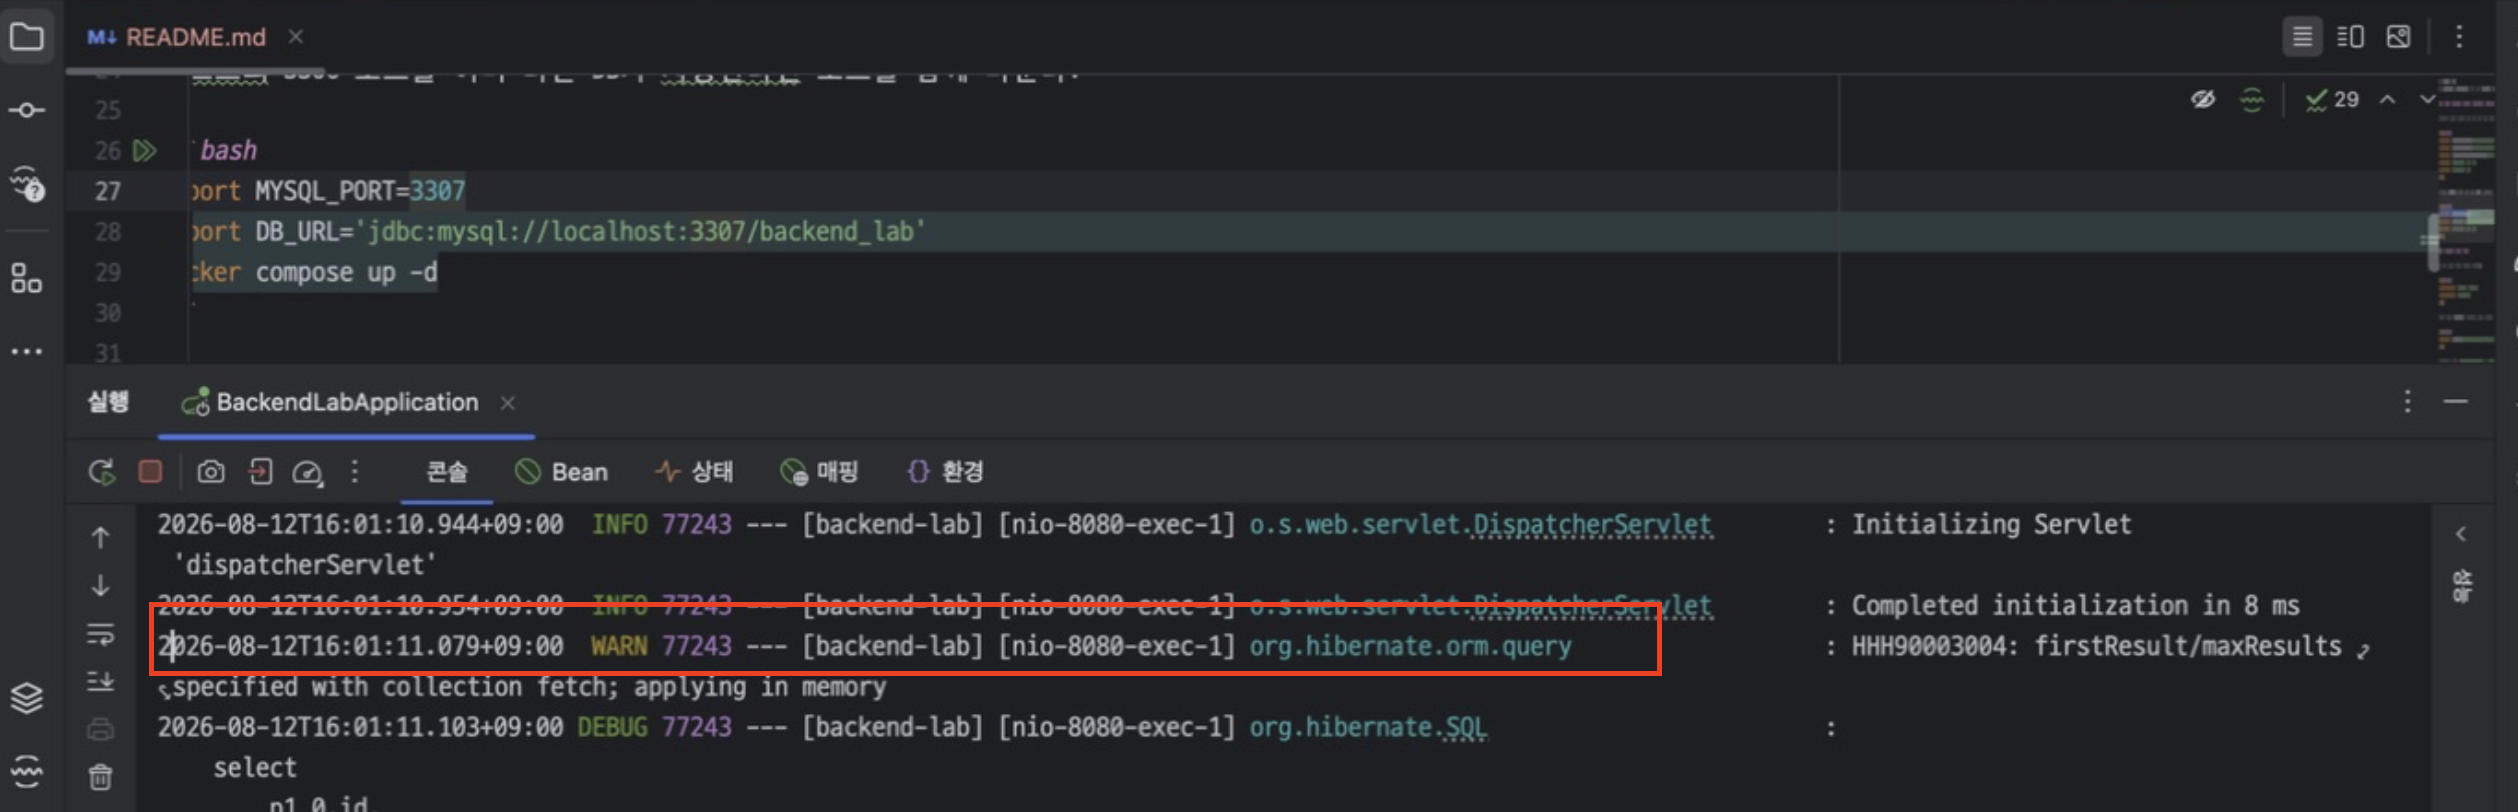
해당 요청에서 실행된 데이터 SELECT에는 limit과 offset이 없었다.
별도의 count SELECT만 실행됐다.
| 항목 | 결과 |
| 요청 | page=0, size=10 |
| API 반환 Post | 10개 |
| 고유 Post ID | 10개 |
| 데이터 SQL limit | 없음 |
| 데이터 SQL offset | 없음 |
| count SELECT | 1회 |
| Hibernate warning | 발생 |
이번 실행에서는 SQL에서 바로 limit/offset을 적용하지 않고 Hibernate가 메모리에서 Pagination을 처리했고, 그 사실을 warning으로 확인할 수 있었다.
이번 데이터는 Post 100개뿐이기 때문에 이것만 가지고 성능 문제가 발생했다고 단정하지 않았다.
다만 페이징이 필요한 조회에 Collection Fetch Join을 사용할 때는 실제 생성 SQL을 확인해야 한다는 점은 분명히 확인할 수 있었다.
8. 해결 후 다시 고민한 점 — SQL 한 번이면 항상 좋은가?
처음에는 N+1 문제를 확인하면서 SQL 개수를 줄이는 것이 가장 먼저 보였다.
Baseline
SELECT 11회

Fetch Join
SELECT 1회

EntityGraph
SELECT 1회
하지만 Collection까지 Fetch Join하면서 다른 부분이 보이기 시작했다.
ManyToOne Fetch Join
→ 추가 Member SELECT 제거

Collection Fetch Join
→ DB JOIN Row 증가

Collection Fetch Join + Pageable
→ 메모리 Pagination warning 발생
SQL 한 번이라는 숫자만 가지고 조회 전략을 판단하기 어려웠다.
연관관계가 단건인지 Collection인지, 페이징이 필요한지, JOIN 결과가 얼마나 커지는지도 함께 봐야 했다.
9. 정리 — N+1 해결보다 조회 상황을 보는 것이 중요했다
이번 실험에서는 findAll()로 Post를 한 번 조회했다고 해서 실제 DB 조회도 한 번으로 끝나는 것은 아니라는 점을 직접 확인했다.
Post 100개와 Member 10개를 사용한 Baseline에서는 Post SELECT 1회 이후 Member SELECT가 10회 추가로 실행됐다.
Fetch Join과 EntityGraph에서는 같은 조건에서 추가 Member SELECT가 발생하지 않았고 전체 SELECT는 각각 1회였다.
하지만 Fetch Join을 Comment Collection까지 확장하자 DB JOIN 결과가 100 Row가 아니라 103 Row가 됐다.
Collection Fetch Join과 Pageable을 같이 사용했을 때는 SQL에 limit/offset이 생성되지 않았고 Hibernate가 메모리 Pagination을 적용한다는 warning도 확인했다.
처음에는 N+1이 발생하면 Fetch Join으로 해결하면 된다고 생각하기 쉬웠다.
실제로 실험해보니 조회 전략을 선택할 때는 단순 SQL 개수보다 현재 API가 어떤 연관관계를 필요로 하는지, Collection을 조회하는지, Pagination이 필요한지까지 함께 판단해야 했다.
다음에는 대량의 게시글 데이터를 준비하고 Offset Pagination이 뒤쪽 페이지로 갈수록 DB에서 어떤 방식으로 처리되는지 직접 확인해볼 예정이다.
'Backend' 카테고리의 다른 글
| 복합 인덱스는 왜 컬럼 순서에 따라 달라질까? PostgreSQL 실행계획으로 확인하기 (0) | 2026.08.17 |
|---|
